Par Codescooper
Comment passer d’une illustration à un personnage 3D reconnaissable, modifiable et animé dans une branche expérimentale ? Le projet AWEMA a traversé des blockouts, trois pistes de génération et plusieurs reprises du visage et des tresses. Son intérêt tient autant aux progrès obtenus qu’aux erreurs documentées. Voici ce que ce chantier peut apprendre aux développeurs et aux créateurs qui veulent travailler avec Blender et l’IA.
Deux branches sont distinguées dans cet article : le modelage V01–V08 autour du petit original, et le Reconstruction Engine autonome, avec une autre référence prioritaire. Les aperçus animés ci-dessous proviennent du second projet ; ils ne prouvent pas que la géométrie de V08 a été riggée.
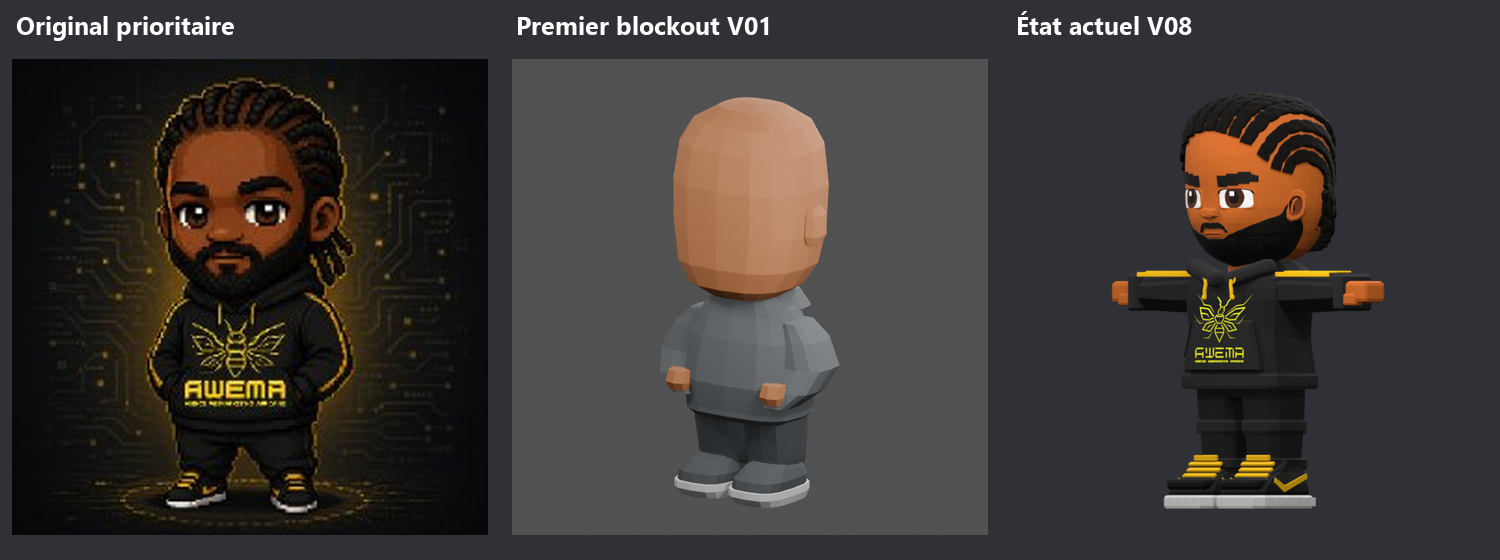
De l’image de départ au modèle V08 de la branche de modelage. Les poses, caméras et éclairages historiques diffèrent : cette planche présente le parcours, pas un score de fidélité.
Le premier modèle avait un corps, mais pas encore l’identité
Dans le premier blockout AWEMA, la tête était un grand volume facetté, les vêtements des masses grises et les mains de petits blocs visibles devant le hoodie. L’ensemble tenait debout. Pourtant, la silhouette ne retrouvait pas celle du personnage de référence.
Cette étape a révélé une distinction utile : construire une géométrie correcte et reconstruire un personnage sont deux problèmes différents. Un fichier peut s’ouvrir, un script peut terminer et les objets peuvent être bien nommés, alors que le visage reste étranger au modèle attendu.
AWEMA devait garder une grande tête chibi, un regard calme et assuré, une barbe courte, des tresses plaquées et un hoodie noir et jaune. Chacun de ces éléments semblait simple à isoler. Leur relation était beaucoup plus difficile à restituer.
La V02 a donc commencé par les masses : tête moins verticale, bras rapprochés, mains davantage enfouies dans la poche, jambes plus pleines. Les détails du visage ont attendu. Cette décision évitait de consacrer du temps à des yeux ou à une barbe posés sur une mauvaise base.
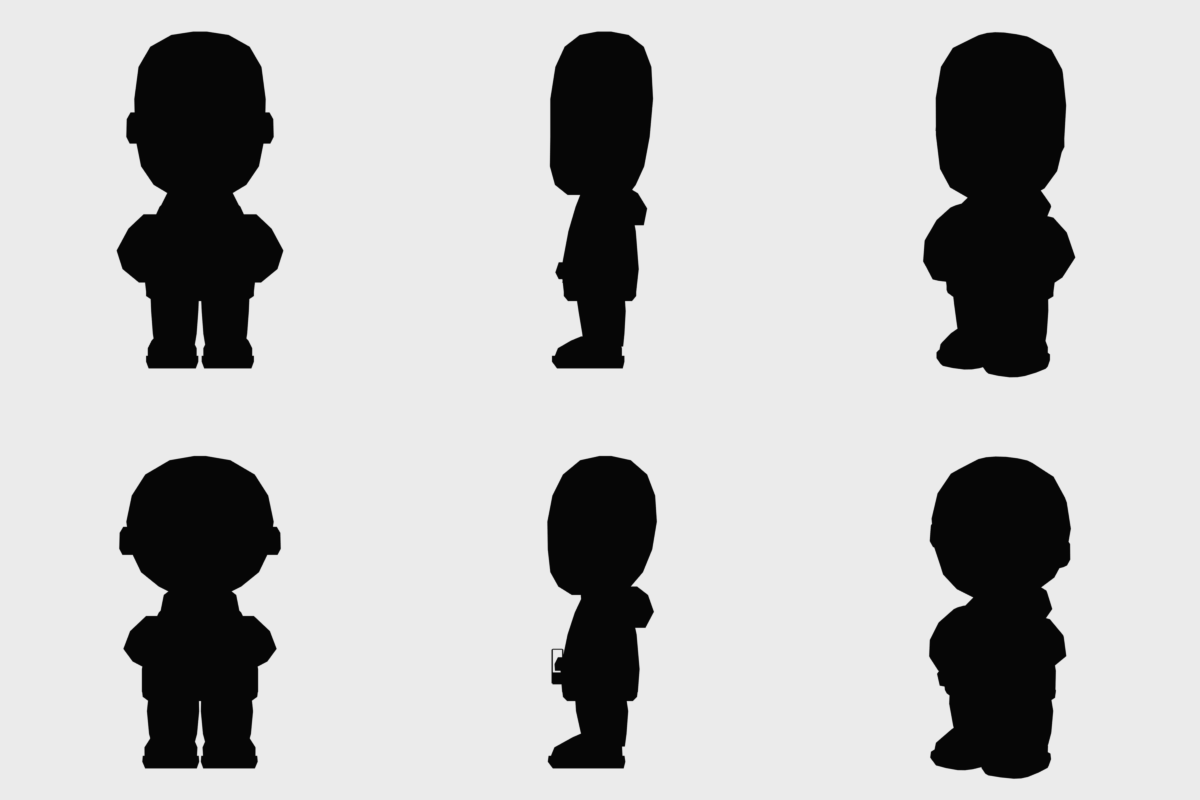
V01 en haut, V02 en bas. Le tassement de la tête et le rapprochement des bras se lisent avant l’ajout du visage et des cheveux.
Choisir la bonne référence avant de choisir le bon outil
Le projet disposait d’un petit original de 256 × 256 pixels et de grandes planches montrant le personnage de face, de dos ou en T-pose. Les images détaillées étaient utiles pour comprendre les volumes cachés. Elles n’étaient pas parfaitement cohérentes avec l’original.
Le rapport tête-corps, l’ouverture des yeux, l’implantation des cheveux et même l’interprétation du logo pouvaient varier. Une indication comme « tête à 55 % » ne suffisait pas : mesure-t-on le crâne nu, la coiffure ou la tête avec la barbe ?
La branche de modelage V01–V08 a retenu le petit original comme priorité d’identité, avec les autres vues comme aides. D’autres essais avaient utilisé une référence haute définition différente. Leurs scores ne peuvent donc pas être alignés dans une seule courbe de progrès.
La même règle s’applique à une mascotte de marque, à un avatar de jeu ou à un personnage pédagogique : décider quelle image fait autorité avant de lancer la reconstruction. Sinon, chaque correction risque de rapprocher le modèle d’une image tout en l’éloignant d’une autre.
Trois pistes de génération, avec des conditions différentes
SculptMate, Hunyuan3D-2 et TRELLIS ont été comparés sur le projet. Mais il faut préciser ce qui a réellement été fait :
- SculptMate Lean, fondé sur TripoSR, a produit deux générations locales sur CPU. L’essai à résolution 256 a pris environ 159 secondes dans l’environnement utilisé.
- Hunyuan3D-2 a fourni une géométrie calculée sur une démo distante officielle. Les tentatives de génération avec texture ont échoué : l’apparence colorée obtenue ensuite venait de retouches et de projections dans Blender.
- TRELLIS était représenté par un fichier fourni par l’utilisateur, généré depuis la vue frontale en T-pose. Il a été importé et inspecté ; aucune nouvelle inférence TRELLIS n’est revendiquée pour cette comparaison.
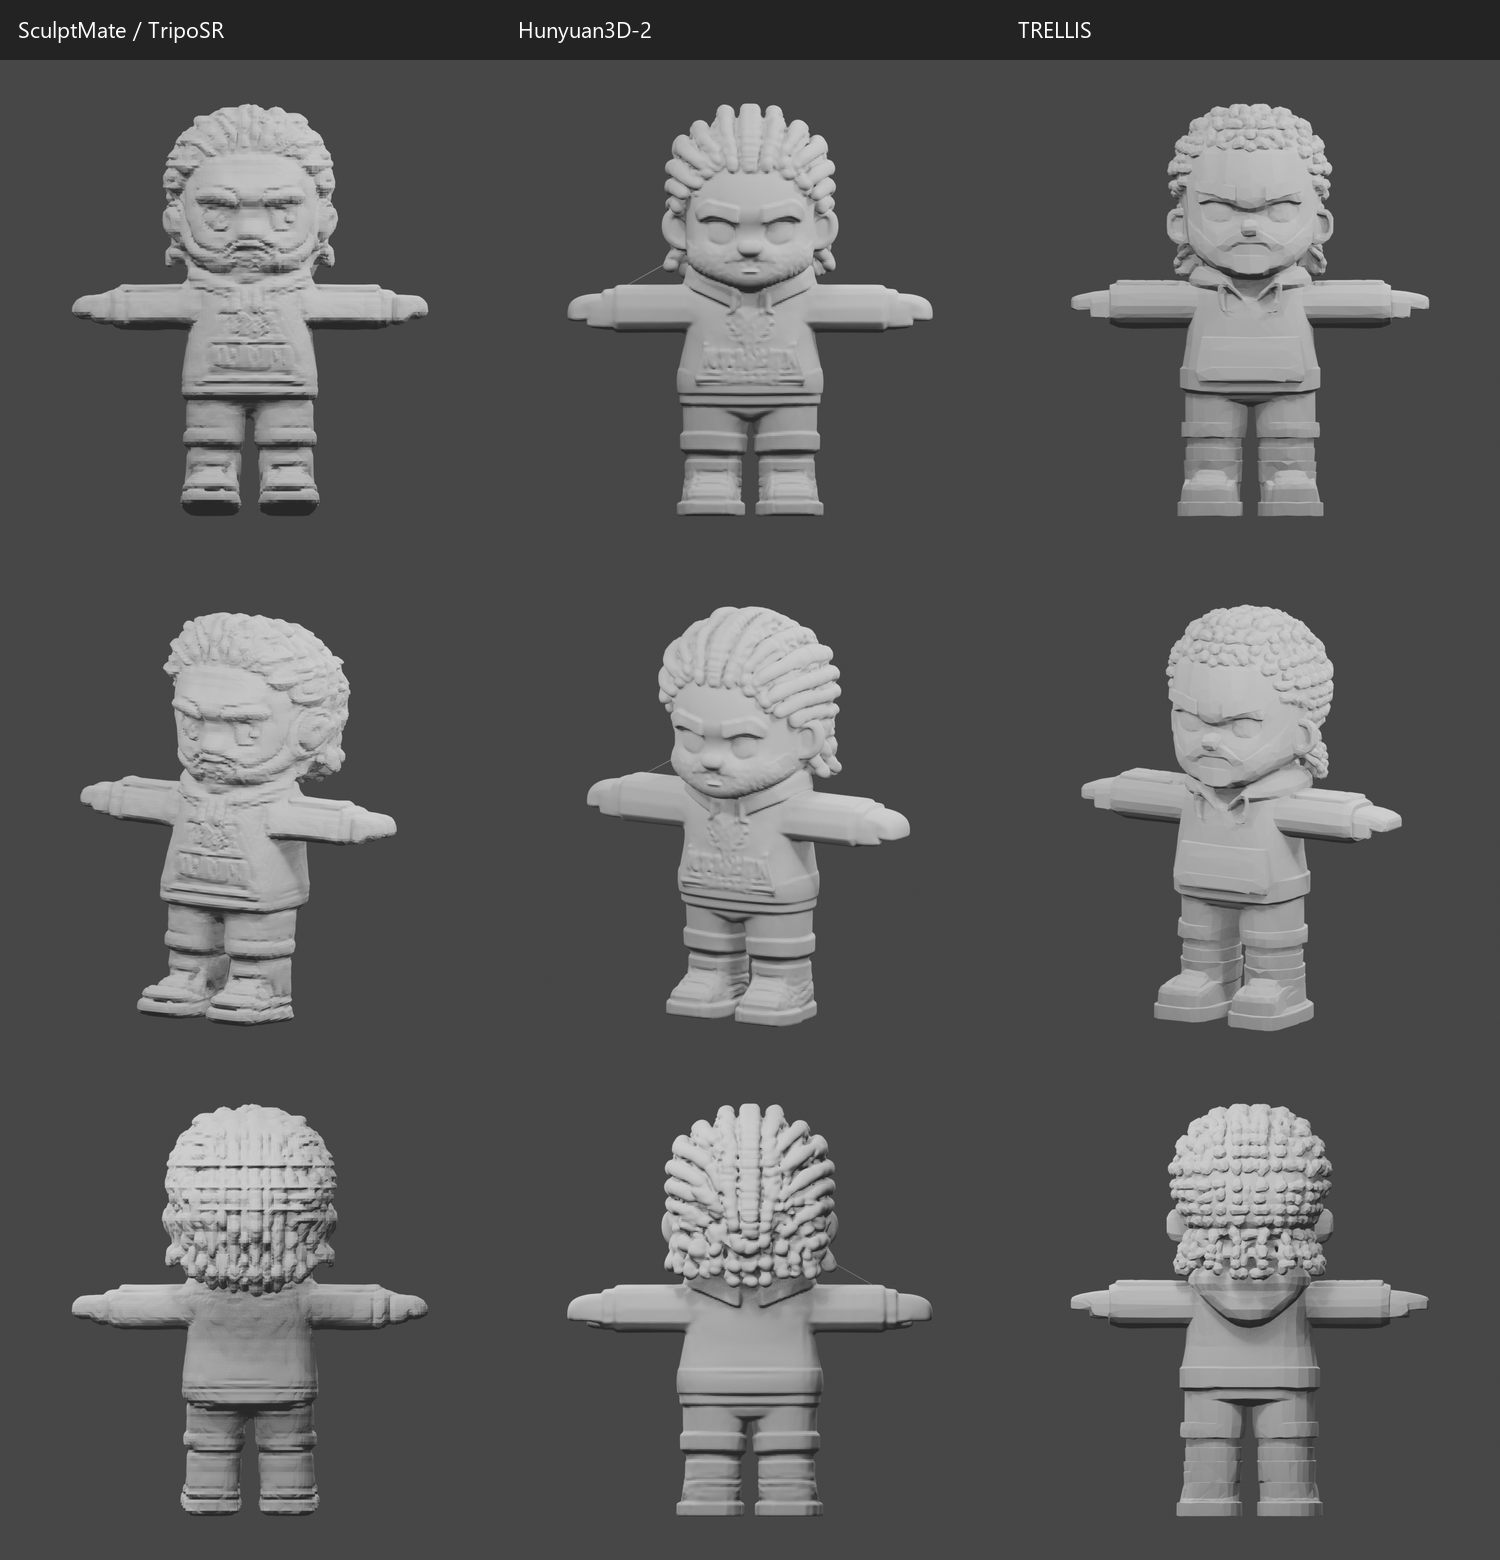
Les trois sorties brutes sous un dispositif commun. SculptMate a été calculé sur CPU ; Hunyuan provient d’une génération de forme distante ; TRELLIS est le fichier fourni par l’utilisateur. La comparaison en gris isole les volumes des textures.
La machine de cette passe disposait notamment d’une carte MX150 de 4 Go et d’un environnement d’inférence CPU. Ces conditions ont orienté les choix. Une durée mesurée sur CPU local ne peut pas être comparée directement à celle d’un service GPU hébergé.
Pour un studio, un indépendant ou un atelier de formation, cet inventaire du matériel disponible évite de bâtir tout un processus autour d’une démonstration impossible à reproduire sur place.
Les sorties apportaient des masses intéressantes. Elles ne livraient pas un personnage terminé : logos déformés, traits approximatifs, tresses tubulaires ou formes fusionnées. TRELLIS était léger ; Hunyuan retouché a ensuite été jugé plus convaincant pour le visage dans une passe donnée. Aucun classement ne suffisait à décider de la bonne topologie pour l’animation.
Pourquoi revenir à des composants éditables
Les reprises ont progressivement séparé le crâne, les yeux, les paupières, les sourcils, le nez, la bouche, la barbe et les cheveux. L’intérêt était de pouvoir corriger une relation précise sans remodeler tout le personnage.
Une erreur récurrente consistait à ajouter du relief pour compenser un volume incorrect. Une barbe pouvait devenir plus détaillée tout en gardant une forme de tablier. Des yeux pouvaient être plus brillants tout en paraissant trop globuleux.
La V06 a repris le regard avec des surfaces conformées au crâne, des paupières continues et des régions de matériaux pour l’iris, la pupille et le reflet. La V07 a retravaillé la barbe et les oreilles. La V08 a ensuite arrondi le crâne, resserré la mandibule, compacté le nez et repris les iris et la moustache.
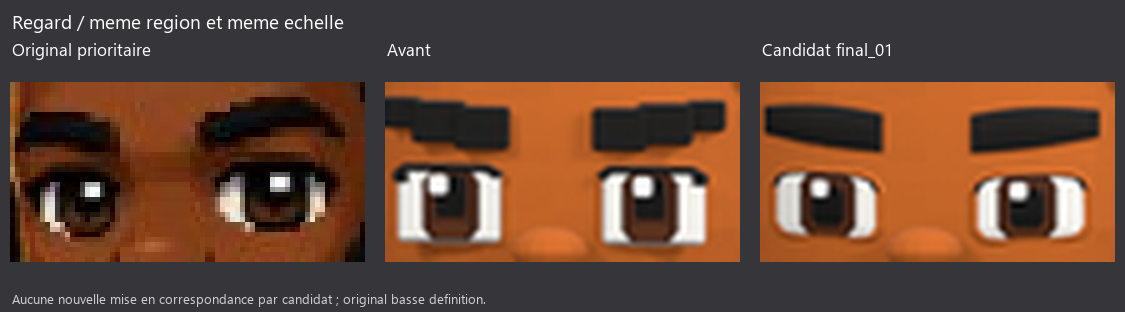
La passe V06 reprend le volume des yeux et des paupières. « final_01 » est le nom du checkpoint de cette passe, pas une validation finale du personnage. Le calage avec l’original reste approximatif.
Le code Python bpy a servi à exposer ces réglages et à produire des essais reproductibles. Lorsque la connexion MCP ne répondait plus, les opérations ont été exécutées dans des processus Blender séparés, sur des copies. Ce repli permettait d’avancer ; il ne prouvait pas que la connexion live était rétablie.
Les tresses ont obligé à revoir la méthode
Dans AWEMA, les cornrows participent directement à l’identité. Leur sens, leur implantation et leur volume arrière comptent autant que leur couleur.
Les premiers systèmes conservaient des courbes de trajectoire. Mais modifier une courbe ne changeait pas automatiquement le maillage correspondant : il fallait le régénérer. Une courbe présente dans la scène n’est donc pas, à elle seule, une preuve d’éditabilité.
La branche de modelage V08 utilise des Geometry Nodes pour générer le volume depuis les guides. Le couplage a été testé en déplaçant temporairement un point, en observant la géométrie évaluée, puis en restaurant son état.
Un autre piège est apparu : épaissir toutes les rangées pour réduire les raies pouvait les fusionner en casque. La solution a demandé de distinguer largeur, profondeur, trajectoire, segmentation et espacement local.
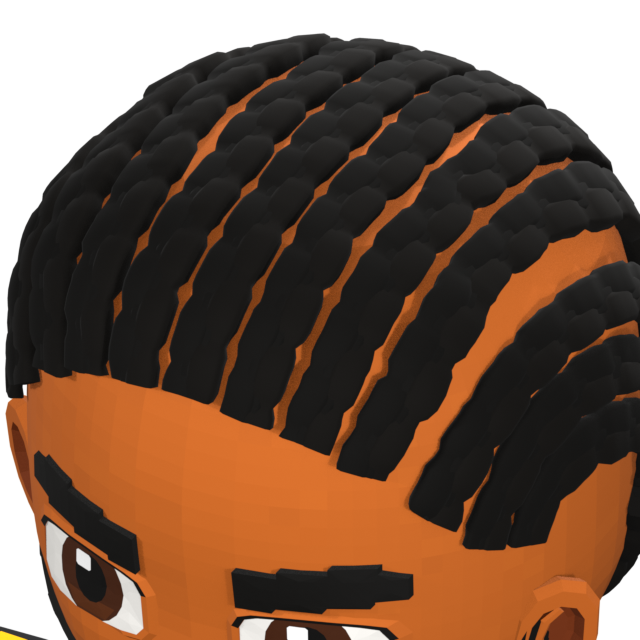
Les tresses suivent des guides éditables. La séparation des rangées progresse, mais la grande raie temporale et le rythme répétitif restent à corriger.
La V08 conserve treize trajectoires principales et treize terminaisons. Ce nombre décrit la structure de travail, pas un compte certifié des cheveux cachés dans l’illustration. Les volumes restent éditables, mais leurs recouvrements internes ne constituent pas encore un maillage soudé validé pour le skinning.
Ce que la V08 réussit et ce qu’elle ne réussit pas encore
La V08 donne un crâne moins carré, un nez moins saillant, des iris ovales plus vivants et une moustache plus compacte. Les tresses se lisent davantage comme des rangées distinctes.
Les contrôles de réouverture ont confirmé la conservation des éléments protégés, des matériaux et des caméras. Les anciennes versions sont gardées. Le logo officiel est utilisé comme ressource protégée, sans le remplacer par une abeille ou une police approximative.
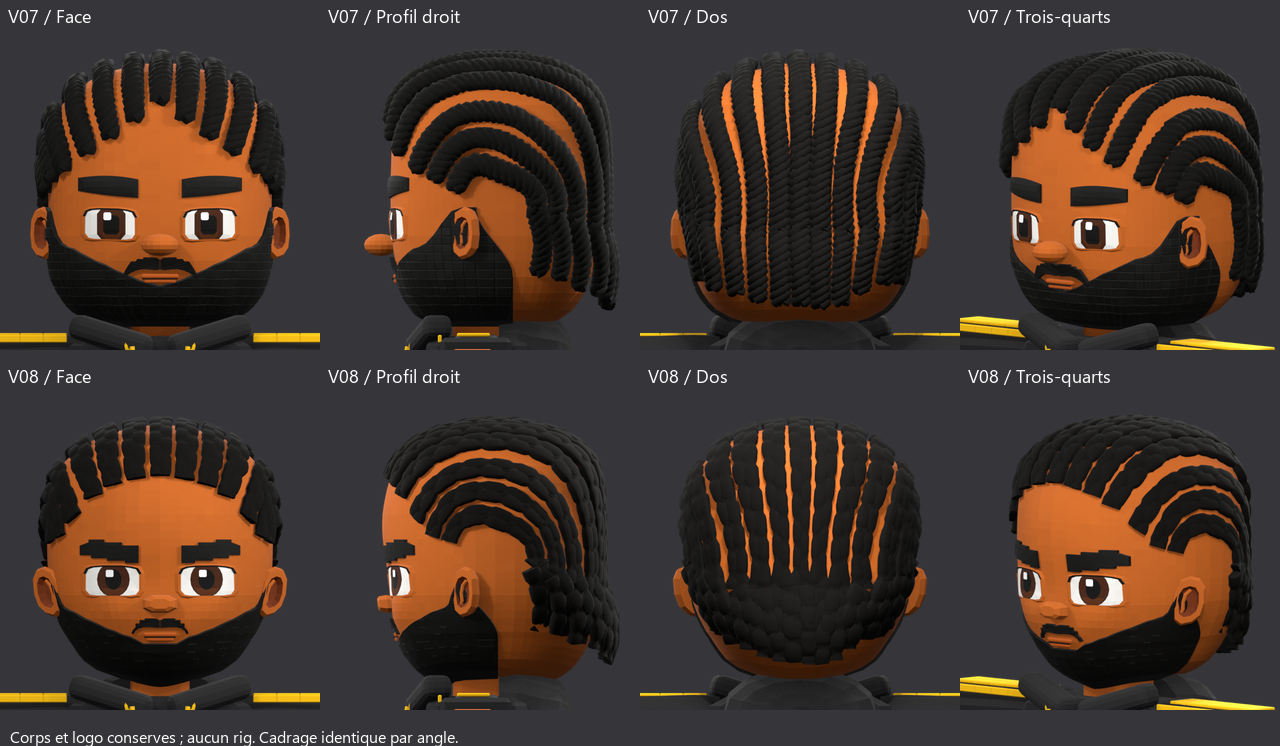
V07 en haut, V08 en bas, avec les mêmes caméras et le même éclairage. Le crâne, le nez, les iris et la barbe ont évolué ; le corps et le logo sont conservés. Aucun rig dans cette V08.
La fidélité complète n’est pas atteinte. Les sourcils restent rigides, la barbe forme encore une coque importante de profil et la raie temporale domine la coiffure. Le calage vers l’original reste approximatif.
Il faut aussi séparer les branches : le Reconstruction Engine indépendant a produit un rig et les tests de locomotion et de parole présentés plus bas. La V08 de cette branche de modelage n’a aucune armature. Ces anciens clips ne prouvent pas que ses nouvelles surfaces sont déjà prêtes à se déformer.
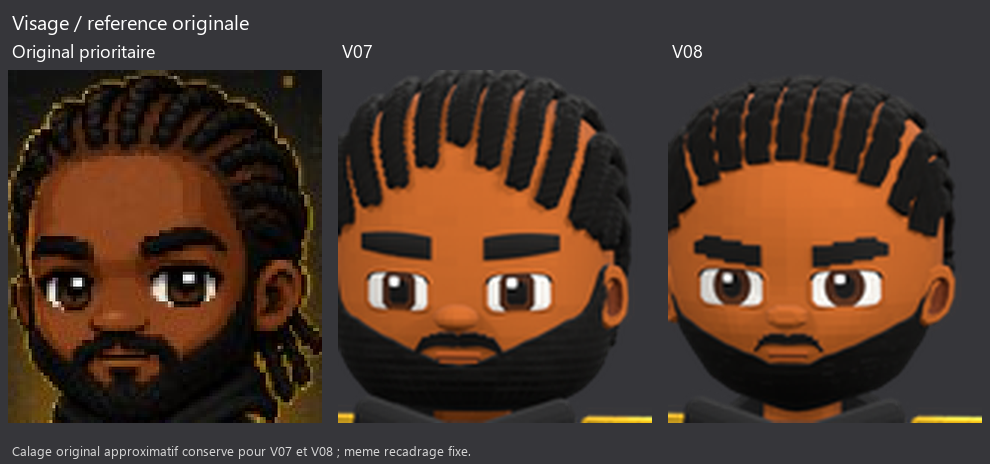
L’original reste le juge d’identité de cette branche. Les iris sont moins mécaniques en V08, mais les sourcils, la moustache et la masse de barbe gardent des écarts visibles. Aucune fidélité à 100 % n’est revendiquée.
Un second chantier pour reconstruire, mesurer et animer
Le projet AWEMA a aussi ouvert une branche indépendante, AWEMA 3D Reconstruction Engine. Son premier mandat était volontairement limité : construire une tête, la rendre, la comparer aux références, puis corriger des défauts observables. Cette branche utilisait une autre image prioritaire, en trois-quarts et en 1254 × 1254 pixels. Les vues synthétiques complémentaires servaient à formuler des hypothèses sur les volumes cachés ; leurs proportions et leurs mesures imprimées n’étaient pas une vérité physique.
Les quatre premiers candidats ont été exécutés sous Blender 4.3.2, avec Cycles sur CPU. Un résultat a rappelé pourquoi il faut lire plusieurs mesures : entre V01 et V04 de ce pilote, la similarité structurelle SSIM passait de 0,395 à 0,442, tandis que le recouvrement de silhouette IoU baissait de 0,852 à 0,802. La régression de contour est restée dans le rapport. Le dernier candidat était un checkpoint de travail, pas une victoire globale.
La construction du personnage complet, les affinages et les tests d’animation ont ensuite utilisé Blender 5.2.3 LTS. Avant de retoucher encore le visage, 23 repères ont servi à ajuster la caméra au cours de 18 essais bornés. L’erreur pondérée de projection est passée de 100 à 14,26 pixels. Cela reste un calage approximatif d’une image stylisée, et les scores obtenus sous des dispositifs différents ne s’additionnent pas.
Dans cette branche, treize guides capillaires sont repérés sur la surface du crâne et les maillages sont régénérés explicitement. Ce fonctionnement est distinct du système Geometry Nodes live testé sur la V08 de l’autre chantier.
LPIPS : débloquer l’outil, puis publier aussi les régressions
LPIPS, un outil de comparaison perceptuelle d’images, a d’abord échoué sur un chemin Windows trop long. Un alias de lecteur court avec SUBST et un environnement Python CPU isolé ont permis de l’exécuter, sans modifier le registre, le PATH permanent ni le Python global.
Les essais ont ensuite conservé les mêmes cadrages et régions de comparaison. Pour le candidat retenu, les distances obtenues étaient les suivantes :
| Région comparée | Avant | Après |
|---|---|---|
| Yeux et sourcils | 0,230384 | 0,222726 |
| Région des tresses | 0,252280 | 0,247927 |
| Barbe seule | 0,262804 | 0,264074 |
La distance diminue de 3,32 % pour les yeux et sourcils, et de 1,73 % pour la région des tresses. La barbe seule régresse légèrement. Ces variations ne sont pas des pourcentages de fidélité gagnée. Le rectangle des tresses inclut aussi le haut des sourcils : il ne s’agit pas d’un masque pur des cheveux.
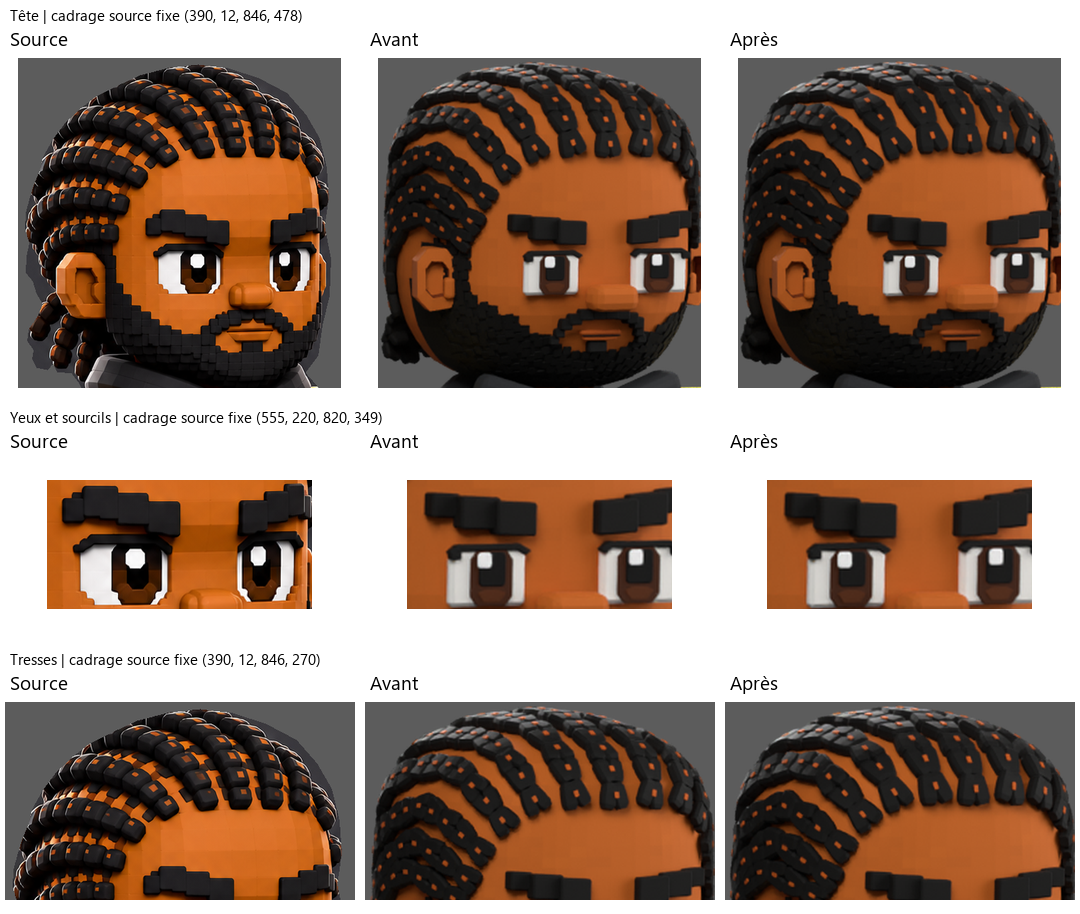
Même dispositif pour ce lot de corrections. Les images et les distances sont examinées ensemble ; une moyenne ne doit pas effacer la petite régression locale de la barbe.
Du premier salut à une arrivée qui marche et parle
Le premier test vertical durait six secondes, en 720 × 1280 à 24 images/s, sans audio. AWEMA saluait avec les pieds plantés. Il permettait déjà de vérifier le rig de 17 os, les paupières et les sourcils.
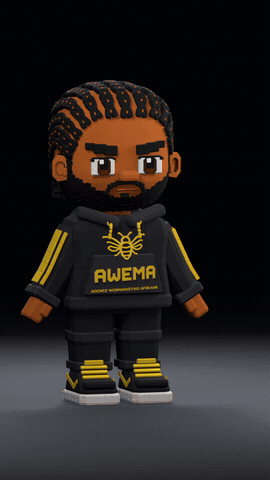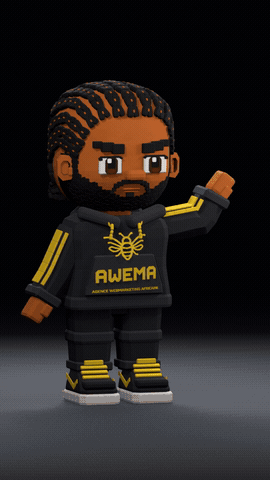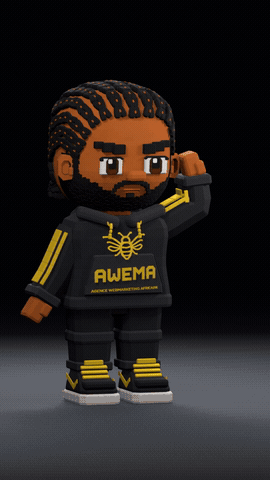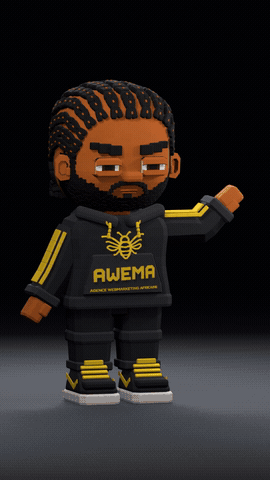
Extrait animé muet de 4,5 secondes du premier test de six secondes. Les pieds restent fixes ; ce n’est pas encore un test de locomotion. L’aperçu s’arrête après une lecture.
Le nouveau test dure douze secondes, en 1080 × 1920 à 24 images/s. Il ajoute quatre pas sur 1,2 unité, un freinage, une adresse au spectateur, une main tendue vers la caméra, un salut et un clin d’œil. La séquence complète comporte une voix synthétique française standard, non clonée : « Salut, c’est AWEMA. On avance ensemble ? » Quatre bruitages doux sont calés sur les vrais contacts des pieds.
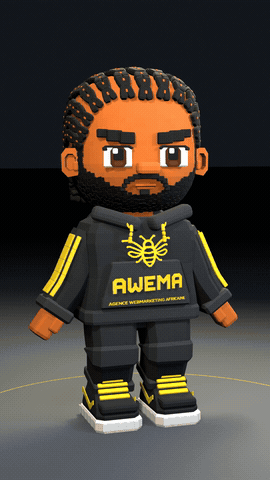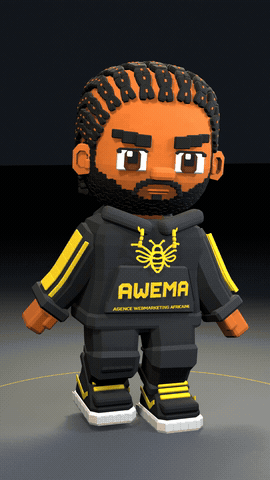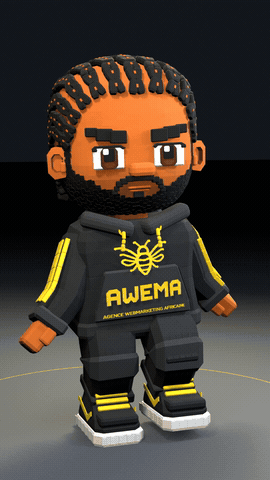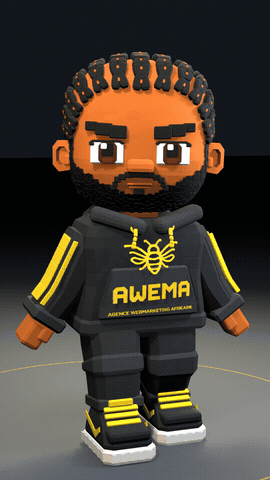
Extrait animé muet de 4,5 secondes : l’arrivée et les quatre pas. Il ne contient pas la parole ni la fin du film de douze secondes. L’aperçu s’arrête après une lecture.
Les jambes sont posées par une résolution analytique puis enregistrées en clés d’animation. Les vérifications portent sur les chaussures réellement évaluées dans Blender, sur 288 frames et 13 demi-frames. Un détail révélateur a été corrigé : trois lacets de la chaussure droite étaient rattachés au pied gauche.
Le rig conserve 17 os et le visage dispose de 71 morphs, des formes de déformation pilotables. Ce nombre ne signifie pas 71 formes de parole : la palette labiale reste limitée à quatre familles simplifiées. Les douze principes d’animation ont guidé les préparations, les transferts de poids, les arcs, le rythme et les mouvements décalés du buste, de la tête et des poignets. Ils donnent des critères pour examiner le jeu ; leur mention ne certifie pas une qualité professionnelle.
Pourquoi une bouche réglée à moitié s’ouvrait complètement
La bouche bougeait, mais certaines transitions étaient trop sèches. Le contrôle a trouvé un écart entre les valeurs prévues et celles relues dans l’animation : des propriétés devenues entières arrondissaient les valeurs intermédiaires. Une commande de 0,5 pouvait devenir 1.
Le correctif a imposé des contrôleurs flottants, puis la scène a été reconstruite et vérifiée après réouverture. Au même instant et avec la même caméra, la demi-ouverture est désormais conservée. Les neuf temps de parole contrôlés retrouvent les poids attendus. C’est une preuve de fonctionnement des commandes, sans garantie de synchronisation phonétique parfaite.
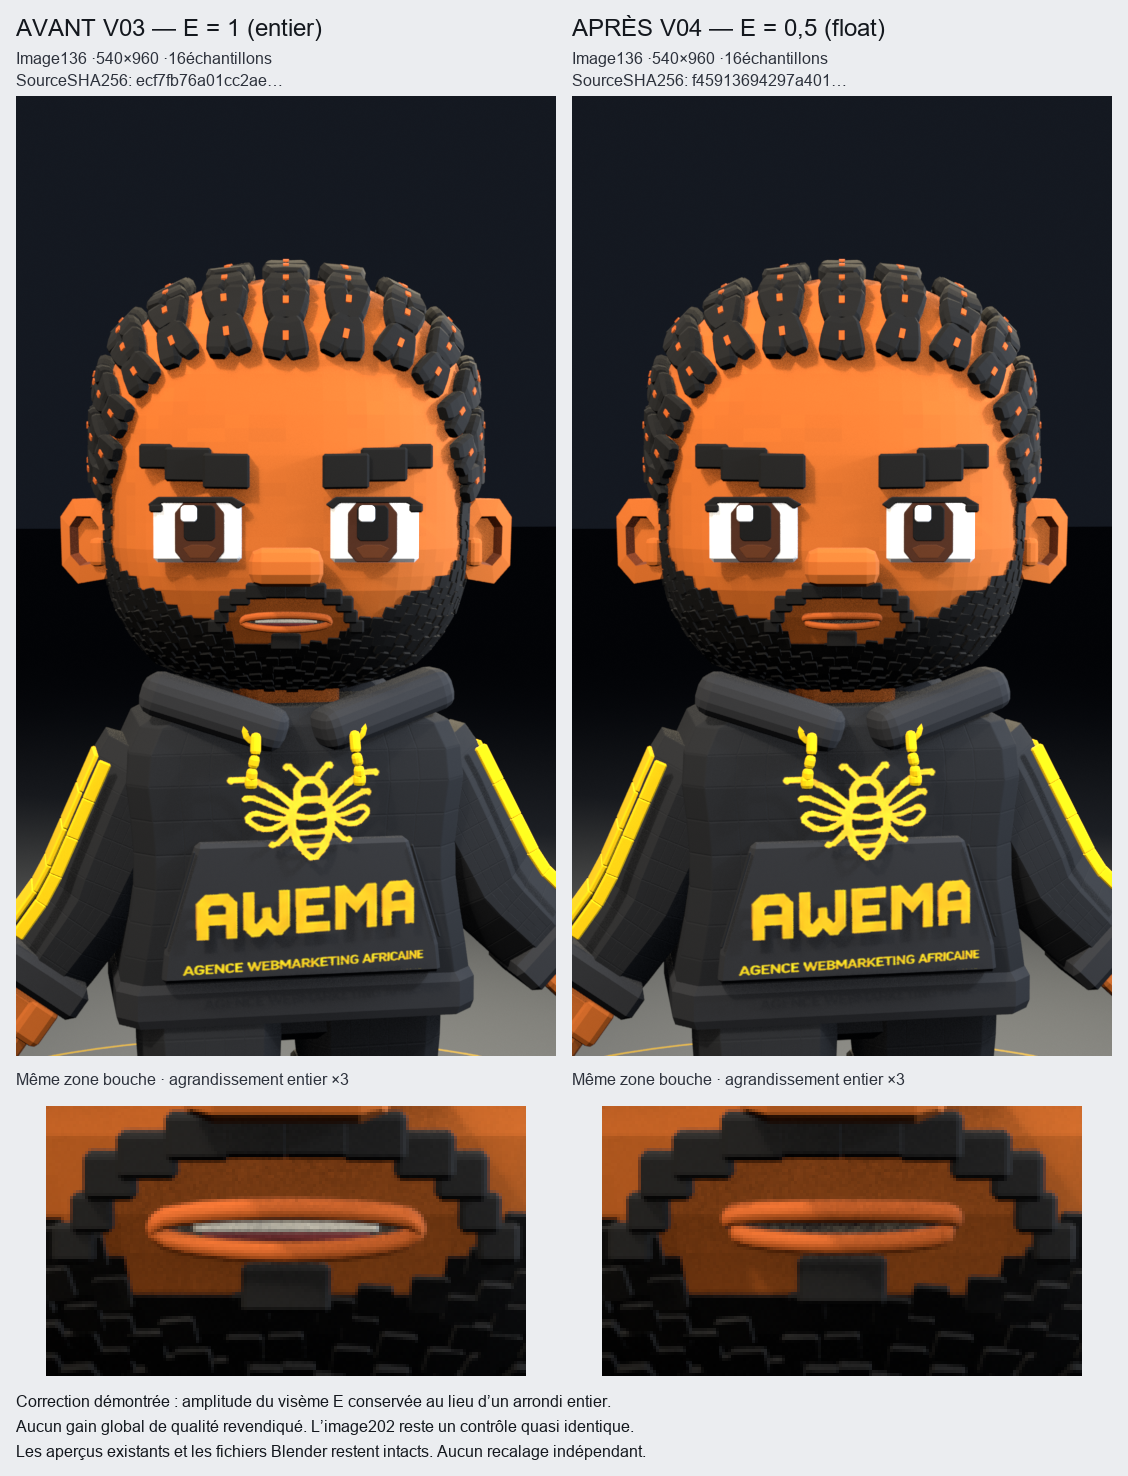
La correction porte sur la lecture du contrôleur, pas sur un score global de ressemblance. Ouvrir le fichier sauvegardé et relire ses valeurs a permis de trouver ce qu’un script exécuté sans erreur ne montrait pas.
La machine et les fichiers font aussi partie du travail
Le GPU MX150 a réellement servi au rendu final, avec des limitations thermiques observées à certains moments. Les journaux consignent environ 79 minutes de rendu actif pour les deux segments du master de douze secondes, hors interruption. Un disque saturé avait aussi tronqué certains fichiers de test ; ils ont été écartés des preuves. Les sorties lourdes et les temporaires ont été dirigés vers un autre disque.
Le rendu a repris après 32 images, dont les empreintes ont été vérifiées avec le même modèle et les mêmes réglages. Conserver les checkpoints, les paramètres, les scripts et les voix a permis de continuer sans recommencer les essais déjà valides.
Le MP4 final passe un décodage audio et vidéo complet. Des images clés ont été inspectées par l’agent, sans présenter cette revue comme une approbation humaine indépendante. Les limites restent visibles : doigts non articulés, tresses rigides liées à la tête, palette de parole réduite et ressemblance encore partielle du visage. Le rig cuit demande du travail pour devenir un outil complet de contrôle de production. Les opérations natives de bouche ne garantissent pas un export animé identique dans tous les formats.
Ces essais rendent la prochaine décision plus précise : quel défaut de forme, de déformation ou de jeu corriger, et avec quelle preuve ? Ils complètent les recherches de V08, sans faire croire que toutes les branches et tous les scores décrivent le même modèle.
Une méthode en six étapes pour votre propre personnage
1. Définissez la cible et préservez la source
Choisissez l’image prioritaire, les vues complémentaires et les traits essentiels. Écrivez ce qui peut changer et ce qui doit rester intact. Sauvegardez une version distincte avant chaque famille d’essais.
2. Validez les masses sous plusieurs angles
Construisez d’abord tête, torse, bras, mains, jambes et chaussures. Rendez face, profil, dos et trois-quarts. Les primitives sont un point de départ ; leurs proportions et leurs transitions doivent être ajustées avant les détails.
3. Figez le dispositif de comparaison
Gardez les mêmes caméras, dimensions d’image, lumière et gestion de couleur pendant un lot de corrections. Une vue orthographique facilite le contrôle des proportions, sans prouver que l’image d’origine était orthographique. Si le calage change, refaites aussi le rendu témoin.
4. Corrigez un défaut précis à la fois
Formulez une hypothèse observable : « le nez dépasse trop en profil » ou « les rangées fusionnent au sommet ». Réglez peu de paramètres. Pour la coiffure, validez une tresse test avant de répéter le système sur tout le crâne.
5. Confrontez les mesures à l’expression
Un score de silhouette peut s’améliorer pendant que le regard se dégrade. Dans AWEMA, un petit gain mesuré sur les ouvertures des yeux variait avec quelques pixels de décalage des annotations. Conservez l’incertitude et inspectez aussi le personnage à sa taille d’affichage finale.
6. Préparez l’animation après la forme
Rouvrez le fichier livré, vérifiez les textures et les composants protégés, puis demandez une validation visuelle. La retopologie, les boucles autour des yeux et de la bouche, les poids et les tests de pose viennent ensuite. Un maillage fermé ou un Remesh réussi ne garantit pas une bonne déformation.
Garder les preuves pour pouvoir apprendre du prochain essai
Le travail AWEMA a gagné en clarté lorsque chaque variante a conservé sa source, ses paramètres, ses rendus et une décision explicite. Un essai rejeté restait utile : il indiquait quelle hypothèse ne fonctionnait pas.
Le point de départ peut être une image et une génération rapide. Pour obtenir un personnage contrôlable, il faut ensuite observer, mesurer, corriger et accepter que certains détails demandent une décision artistique.
Pour votre prochain avatar ou votre mascotte, commencez avec une tête test, une référence prioritaire et quatre vues comparables. Vous aurez un défaut précis à résoudre avant d’engager tout le personnage.
Pour approfondir
- Caméras orthographiques dans l’API Blender
- Lire la géométrie évaluée et ses modificateurs
- Générer un volume avec Curve to Mesh
- Stabiliser la topologie avant les Shape Keys
Illustrations : références et rendus conservés du projet AWEMA. Les comparaisons historiques dont le dispositif diffère sont présentées comme des étapes de travail, sans score global de fidélité.